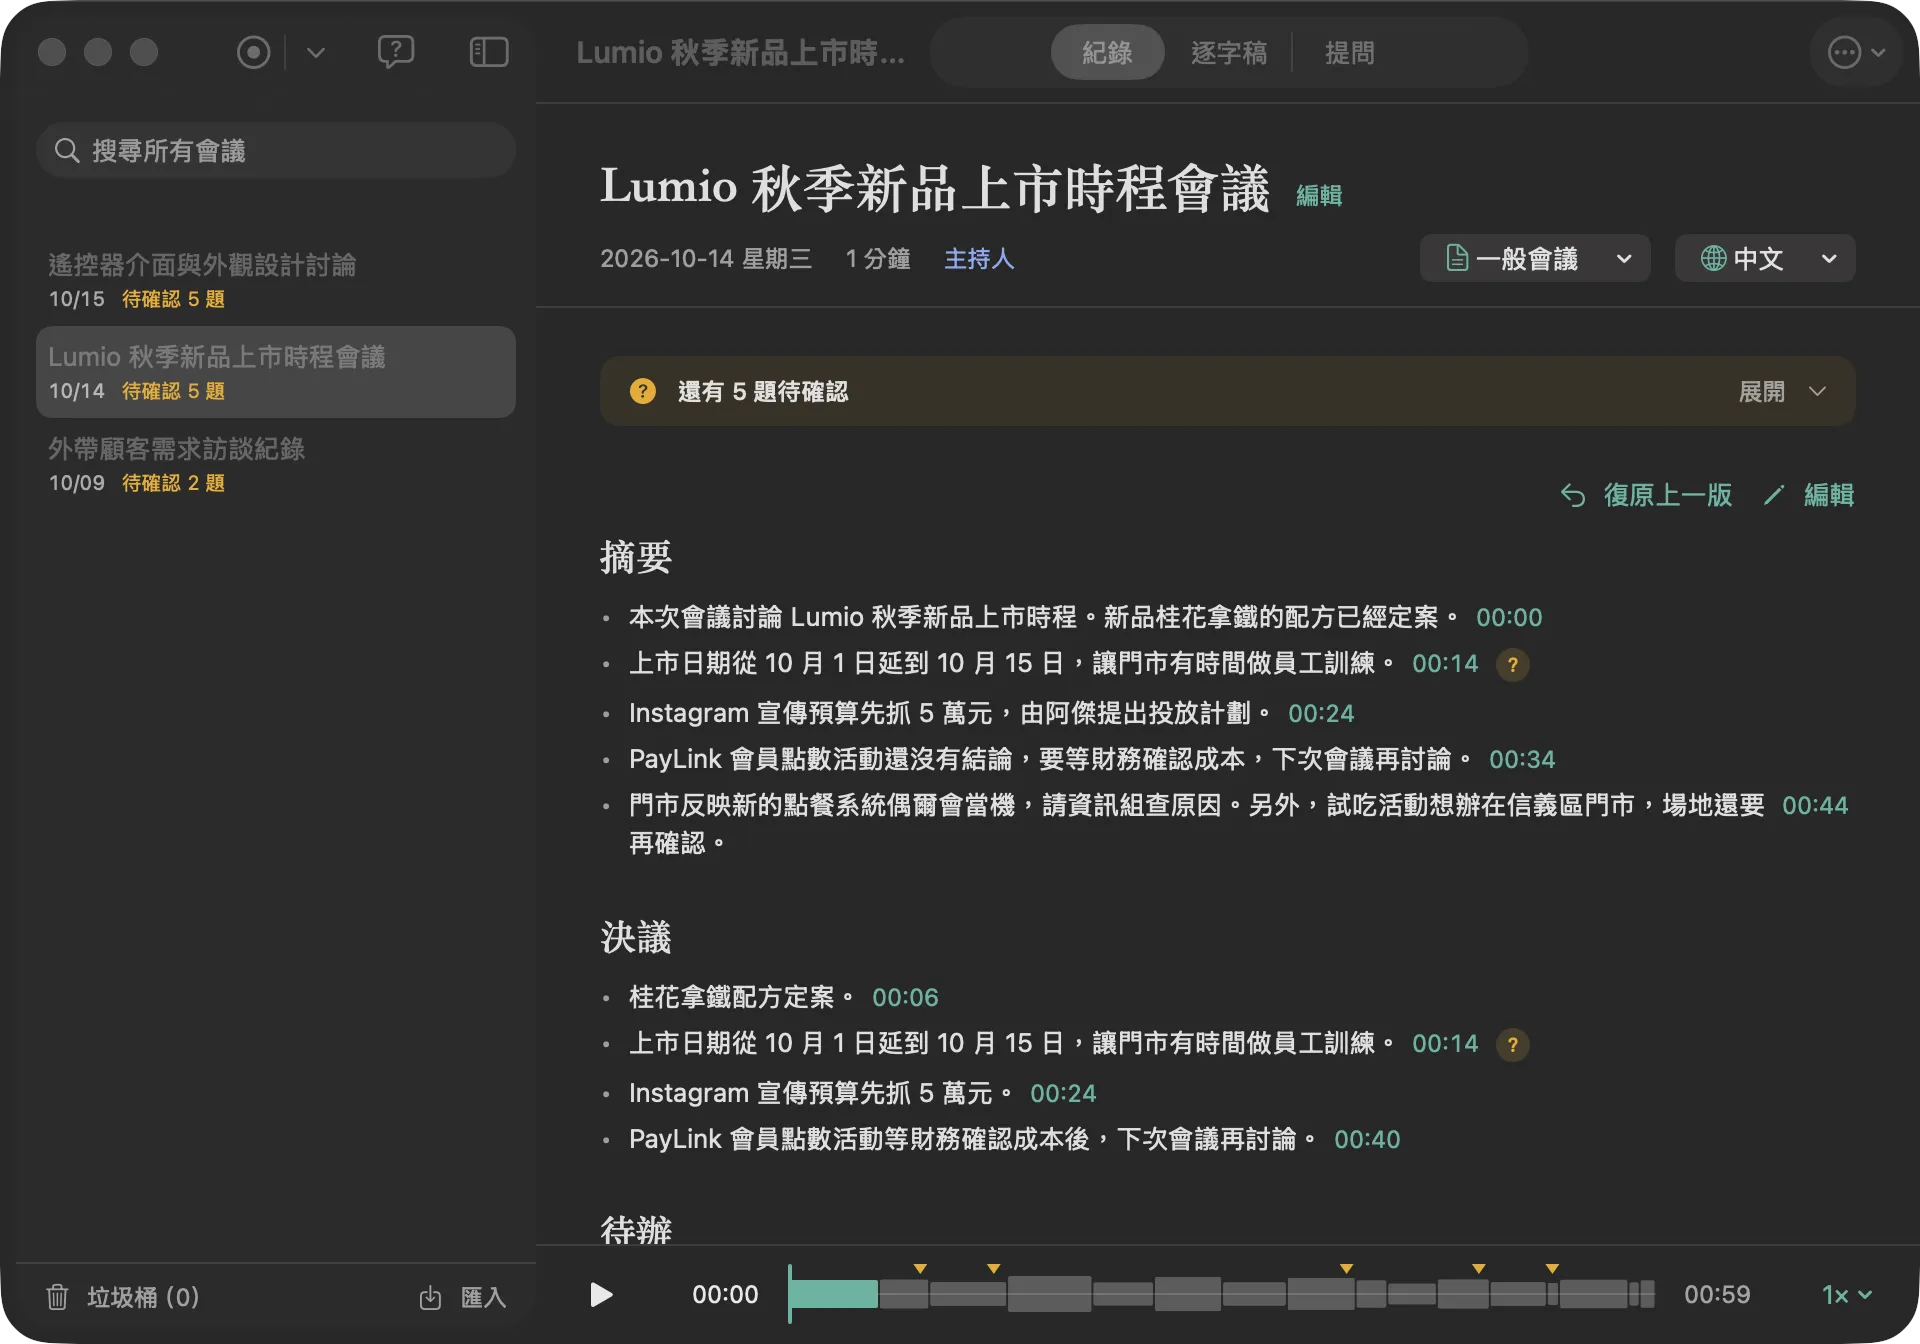
拾音是我做的會議紀錄 app。錄 Zoom、Meet、Teams 不用讓機器人帳號加進會議,錄音、轉錄、分說話者都在自己的電腦上做完。只有整理會議紀錄那一步會把逐字稿交給 AI,用哪一家由你選,也可以選本機的模型或乾脆不整理。
一場會議走過哪些步驟
- 錄音:來源可以是麥克風、電腦聲音,或兩個一起。線上會議選「麥克風+電腦聲音」,對方的聲音也會錄進來。
- 錄音中:左邊是即時逐字稿,右邊是自己的筆記,每換一行就記下錄音時間。按 ⌘B 標記重點。
- 停止後:先拿即時逐字稿整理一份草稿,同時在本機正式轉錄、分出說話者,轉完再把草稿換掉。
- 整理:逐字稿交給 Claude Code、Codex CLI,或 Anthropic、OpenAI、Gemini 的 API,也能接 Ollama、LM Studio 這類本機模型。產出摘要、決議、待辦、未決問題,每一條附時間點。
本機轉錄用什麼模型
中文和英文會議用 whisper.cpp 跑聯發科的 Breeze ASR 25,詞彙表當提示詞餵進去,人名和系統名比較不會寫錯。日文會議改用 Whisper large-v3-turbo,第一次轉日文時才下載。設定裡可以改選 llama.cpp 跑的 Qwen3-ASR 1.7B,多人搶話時漏字少,輸出用 OpenCC 的字表轉成台灣用字,預設還是 Breeze。不想下載模型也可以用 macOS 內建辨識,快很多,但不參考詞彙表。
長錄音分段轉錄,記憶體不會跟著會議長度漲。轉錄加說話者辨識的峰值約 2.9 GB,4 小時的會議也一樣(M3 Pro 實測)。
替說話者取一次名字之後,拾音會記住聲紋,下一場會議自動帶入。聲紋是一組數字,不是錄音,只存在這台電腦的資料庫,不放進匯出的檔案。
需要什麼
- Mac:Apple Silicon、macOS 26 以上、8 GB 記憶體。模型第一次用時下載,約 1.7 GB。
- Windows:Windows 11(x64 或 ARM64),C#、.NET 10、WinUI 3 另外寫的一版,功能跟 Mac 4.1 相同。
- 整理用的 AI:登入過的 Claude Code 或 Codex CLI、一組 API key,或本機的 Ollama、LM Studio。選「不整理」就只拿逐字稿。
我沒有 Apple 開發者帳號,app 沒經過公證,第一次打開會被擋,要到「系統設定 → 隱私權與安全性」按「仍要打開」,只要做一次。Windows 的安裝檔也沒有簽章,SmartScreen 擋下時按「其他資訊」→「仍要執行」。
已知的限制
- 錄音中的即時逐字稿用系統內建辨識,不吃詞彙表,英文專有名詞常錯,例如 Redis 變成 readis。錄完的正式轉錄會用詞彙表修。
- 遠距收音、很多人搶話的會議,錯字以漏掉搶話和語助詞為主。
- 很短、又幾乎只有一個人在講的錄音,話少的人可能被併進別人。
- 還沒有:中、英、日以外的語言,行事曆整合,iPhone 版。
寫過的文章
16 分鐘
拾音在 Apple Silicon 上本機轉錄會議。六人遠距收音的中文會議,Qwen3-ASR 1.7B 字錯誤率 17.5%,Breeze ASR 25 是 25.7%,macOS 內建約 25%。4.1 版把 Qwen3-ASR 放進設定當選項,預設還是 Breeze,理由跟準確度無關。這篇把資料集、每個引擎的數字、換模型要處理的分段與簡轉繁,還有沒採用的方法一次寫清楚。
這頁內容最後對照 repo 是 。