Mac 本機轉錄中文會議誰準:Breeze ASR 25、Qwen3-ASR、macOS 內建實測,還有預設為什麼不選最準的
拾音在 Apple Silicon 上本機轉錄會議。六人遠距收音的中文會議,Qwen3-ASR 1.7B 字錯誤率 17.5%,Breeze ASR 25 是 25.7%,macOS 內建約 25%。4.1 版把 Qwen3-ASR 放進設定當選項,預設還是 Breeze,理由跟準確度無關。這篇把資料集、每個引擎的數字、換模型要處理的分段與簡轉繁,還有沒採用的方法一次寫清楚。
重點
- 六人遠距收音的中文會議(AISHELL-4),去掉語助詞後的字錯誤率 Qwen3-ASR 1.7B 17.5%、Breeze ASR 25 25.7%;英文會議(AMI)兩者差不到 2 個百分點。
- Breeze 的錯有三成五在多人同時說話的地方,解碼參數怎麼掃都差不到 1%,瓶頸是模型本身。
- Qwen3-ASR 不輸出時間點,拾音先辨識說話者、在換人處的安靜點切、每段最長 15 秒;沒有幻覺防線時 AMI 會從 31.6% 惡化到 40%。
- Qwen3-ASR 只出簡體,拾音帶著 OpenCC 的字表自己做最長匹配轉成台灣用字,不帶 OpenCC 程式庫。
- 預設維持 Breeze(聯發科)是產品定位:台灣公司對中國的模型有顧慮。Qwen 在設定裡可選,介面寫明來源、全程本機不連網。
- 日文會議用 Whisper large-v3-turbo,錯誤率 9%;Breeze 會把片假名外來語寫成英文,Qwen 日文 17%。
目錄
拾音是我做的 Mac 會議紀錄工具,錄 Zoom、Meet、Teams 不用機器人,轉錄在本機跑,不把錄音送出去。本機轉錄的模型從第一版起就是聯發科的 Breeze ASR 25,走 whisper.cpp。10 月 24 日那次評估我把 Qwen3-ASR、TEA-ASR 和 macOS 內建辨識一起拉進來比,結果 Qwen3-ASR 1.7B 在六人遠距收音的中文會議上字錯誤率 17.5%,Breeze 25.7%。4.1 版把 Qwen 放進設定裡當選項,預設沒換。這篇把資料集、數字、換模型要多做的事,還有為什麼預設不選最準的,一次寫清楚。評估腳本和資料集清單都在 公開 repo。
拿什麼量
轉錄準不準,要看拿什麼錄音量。乾淨的朗讀句子每個模型都 2% 上下,拉不開差距,會議才會。我用的錄音:
| 錄音 | 內容 | 量什麼 |
|---|---|---|
| AISHELL-4 M_R003S01C01 | 中文會議,6 人,38 分鐘,遠距麥克風陣列收音 | 多人搶話、遠距收音的中文 |
| AMI ES2004a | 英文會議,4 人 | 英文、同時說話 |
| TaiMECS | 100 句台灣國語中英夾雜,20 句真人、80 句聲音複製 | 中英夾雜的句子 |
| 合成的中英夾雜會議 | 91 秒,塞了 6 個產品名、系統名 | 專有名詞(關鍵詞)對幾個 |
| 台大機器學習 2021 課程 | 前 15 分鐘 | 單人講課;Breeze 和 TEA 都拿它訓練過,只當參考 |
| 日本眾議院 AI 法案專家聽證 | 兩段,約 15 分鐘與 10 分鐘,各 6 位說話者 | 日文 |
算分之前先正規化:去標點和空白、中文統一成繁體(AISHELL-4 的答案是簡體)、數字寫法和常見異體字統一。中文算字錯誤率(CER),英文算詞錯誤率(WER),另外算插入、刪除、替換各佔多少,才知道錯的是哪一種。下面的表都是去掉語助詞後的數字,因為 Whisper 系的模型會「整理」口語,把「嗯」「那個」丟掉,算進去會把漏字跟聽錯混在一起。含語助詞的原始數字我也留著,AISHELL-4 上 Breeze 約 29%、macOS 內建約 25%、Qwen 約 18%。
機器是 M3 Pro。評估跑的是 app 真正的轉錄流程,不是另外寫的腳本,所以說話者辨識、分段、詞彙表提示全部照實際使用時的設定來。
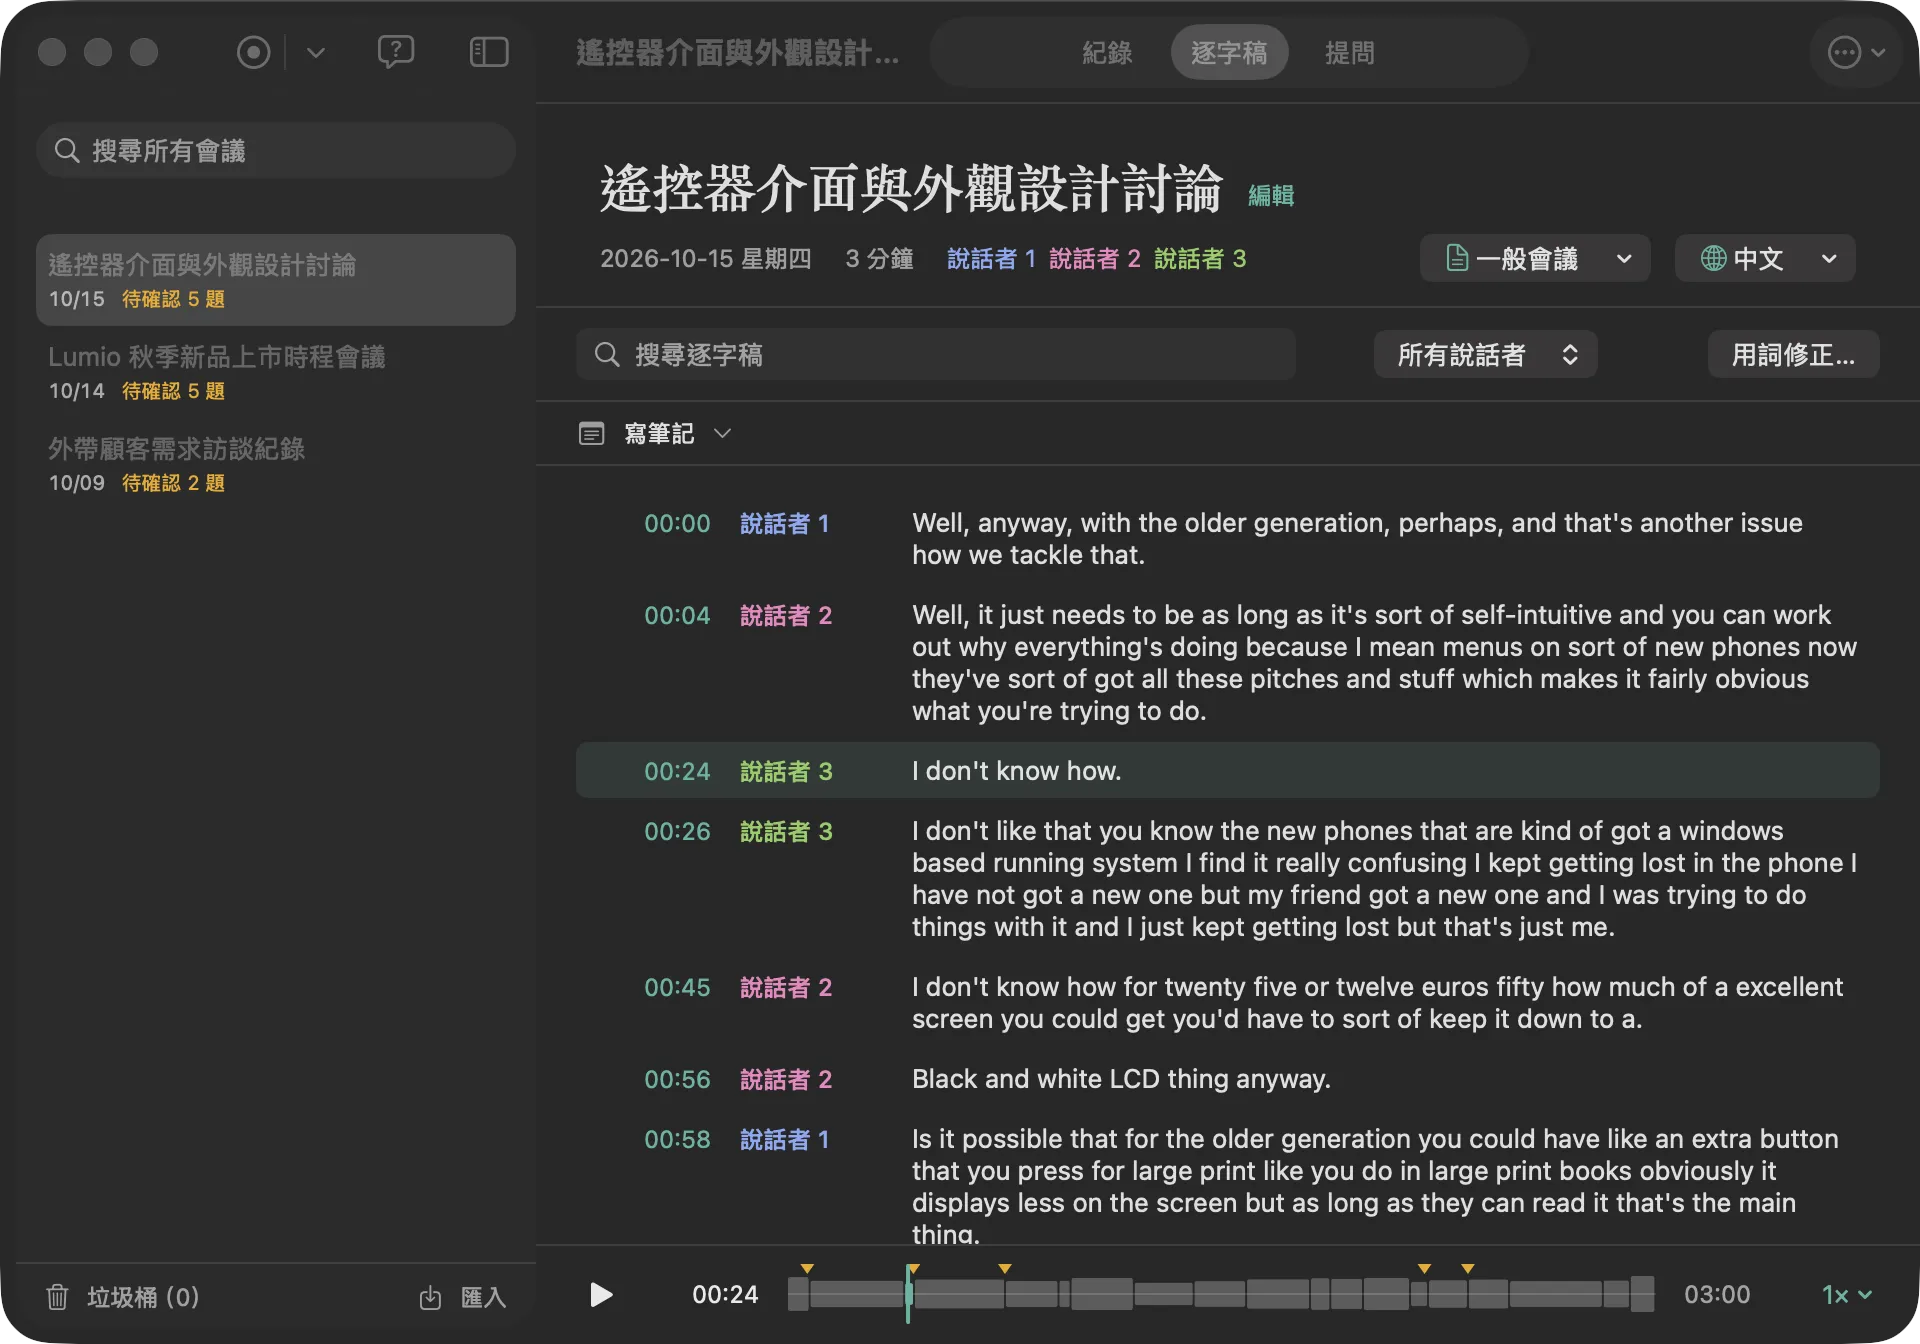
拾音的逐字稿分頁。示範錄音就是 AMI 的 ES2004a,這篇英文的數字都從它來。
數字
完整的表:
| 去語助詞錯誤率 | 合成中英夾雜 | TaiMECS | 台大課程 | AISHELL-4 | AMI 英文 | 日文聽證 | 速度 |
|---|---|---|---|---|---|---|---|
| Breeze ASR 25 q8_0 | 5.2 | 2.0 | 3.8 | 25.7 | 32.6 | 9.0(turbo) | 9 倍速 |
| Qwen3-ASR 1.7B q8_0,30 秒一段 | 2.0 | 1.8 | 16.2 | 31.6 | 17.1 | 17 倍速 | |
| Qwen3-ASR 0.6B q8_0,30 秒一段 | 2.0 | 2.5 | 6.7 | 17.0 | 32.4 | 36 倍速 | |
| TEA-ASR 1.1 q8_0,30 秒一段 | 2.8 | 2.4 | 3.4 | 34.8 | 36.3 | 22.2 | 15 倍速 |
| Qwen3-ASR 1.7B,拾音的實作(預設分段) | 2.0 | 1.8 | 6.6 | 17.5 | 31.3 | 12 倍速 |
速度是音訊長度除以轉錄時間,9 倍速就是 38 分鐘的會議轉 4 分多鐘。macOS 內建辨識沒放進表裡,它在 AISHELL-4 上含語助詞約 25%,跟 Breeze 差不多,而且快 160 倍、不用下載模型;但合成的中英夾雜會議裡六個關鍵詞它只對一個,Breeze 加詞彙表對五個。台灣公司的會議就是中英夾雜,所以它一直是選項,不是預設。
台大課程那欄 Breeze 比 Qwen 好,是因為那份錄音在 Breeze 的訓練資料裡。Qwen 在那裡的「錯」多半是向量名稱的寫法,標準答案寫 a1、a4,它寫 a one、a 四,替換的 136 個字裡約 40 個是這種,不是聽錯。會議的結論以 AISHELL、AMI、TaiMECS 為準。
Breeze 的錯是哪一種
換模型之前先確定不是參數沒調好。用評分腳本的混淆統計看 Breeze 在 AISHELL-4 漏掉的字,35% 落在多人同時說話的地方,另一大塊是語助詞和兒化音,真正聽錯而替換的多是同音字。
然後掃解碼參數:關掉 context、不做降溫重試、beam 開到 8、提示詞改成自然句。每一種跟預設差距都在 1% 以內,不做降溫重試還讓日文從 9.0% 變差到 12.6%。參數沒有空間了,瓶頸是模型。
候選怎麼篩
三個候選各有一個致命傷。
TEA-ASR 1.1 是台灣微調版,原生輸出繁體,乾淨錄音最好(TaiMECS 2.4%)。但吵雜的多人錄音會跳針,「那那那那」一路到被截斷,還會整段漏,AISHELL-4 34.8%,比 Breeze 還差。Q4_K_M 量化更糟,TaiMECS 掉到 31%。日文會把漢字改成繁體,「国」變「國」。
Qwen3-ASR 0.6B 快到 36 倍速,AISHELL-4 也有 17.0%,但單人講課 6.7%,TaiMECS 2.5%,比 1.7B 差一截。省下的時間在會議紀錄這個場景沒意義,反正轉錄是背景跑的。
Qwen3-ASR 1.7B 完全不跳針,數字最好,兩個問題:只輸出簡體,用 context 怎麼導都導不成繁體;而且不輸出時間點。這兩個問題拾音自己處理,下面兩段講。
沒有時間點,段落自己切
whisper 的流程是整段丟進去,它吐出帶時間的段落,再拿段落去配說話者。Qwen3-ASR 整段一次轉(官方最長 20 分鐘)出來是一整坨字,沒有時間,說話者標不了。所以順序要反過來,先辨識說話者,再依說話者的片段切段轉錄。
怎麼切影響很大。我試過的:
- 照標準答案的說話者片段切:重疊處的話被切掉,AISHELL-4 從 16.2% 退到 22.2%,AMI 45.9%。
- 固定長度:10/15/30/60 秒一段,AISHELL-4 是 17.1/16.3/16.2/15.7%,長一點準一點。但 AMI 在 15 秒掉到 39.6%,30 秒是 31.6%。
- 在換人處的安靜點切、每段最長 15 秒:AISHELL-4 17.7%,說話者標對 95.5%。AMI 卻是 40.0%,多出來的 228 個字是短而吵的段落自己編出來的整段話,有一段 19 秒冒出一整段天氣預報。
最後一種加上幻覺防線才能用。每一段「有聲音的秒數」能講的字有上限,英文每秒 5 個字加 3,中日文每秒 8 個字加 4,輸出超過就是在編。超過的段落換一組溫度和種子再解一次,兩次相似度低於 0.6 就丟掉,差不多就留短的那次並標低信心。加上這條,AMI 從 40.0% 回到 32.7%,多出的字從 228 個變 18 個。
還有一條:真的說話者辨識比標準答案粗得多,AISHELL-4 的 38 分鐘只抓到 88 次換人,所以「換人處的安靜點」很少真的切到。補救是一段裡第二多的說話者超過 1.5 秒而且超過這段的 25% 時,照說話者片段的起點再切一次。理想的說話者辨識下 AISHELL-4 說話者標對從 95.5% 到 98.2%,AMI 從 92.4% 到 97.5%,錯誤率各多 0.3 跟 1 個百分點。這是現在的預設。
跳針的處理放在同一段流程裡。結果到達 max_tokens、壓縮比超過 2.4、或同一個一到六字的片段連續出現五次以上就算壞掉。先加重複懲罰、降溫重試;還壞而且這段超過 6 秒就在最安靜處切成兩半各自再來,最多三層;再壞就留壓縮比較低的那次,連續重複縮成三次,標低信心。
簡體轉台灣用字,不帶 OpenCC
Qwen 只出簡體。ICU 的 Hans-Hant 是逐字轉,「頭發」「皇後」這種一對多的字會錯。帶 OpenCC 的 C++ 程式庫要為 Mac 和 Windows 各包一次。最後是拿 OpenCC 的字表自己寫:詞組表 49,238 條、單字表 4,012 條、台灣異體字 40 條,只留每個鍵的第一個候選,約 1 MB。演算法從左到右,先在詞組表找最長匹配(最長 16 字),沒有就查單字,查不到原樣保留,最後套異體字,「臺」寫成「台」。
一個要留意的點:鍵和值相同的詞組要保留。「公里」「皇后」這些條目看起來沒用,是拿來擋逐字轉換的,拿掉之後「公里」會變「公裡」。
用語替換(軟件→軟體)沒做。辨識結果寫的是說話者說出口的詞,人家說「軟件」就寫「軟件」。繁簡也算錯的時候 TaiMECS 2.0%、合成會議 2.0%,還是比原生繁體的 TEA 好。
預設為什麼不換
數字擺在那裡,Qwen3-ASR 1.7B 在中文會議上少 8 個百分點,速度 12 倍對 9 倍,記憶體 2.6 GB 對 2.8 GB,都比 Breeze 好。
預設沒換,是因為拾音的使用者是台灣的公司,阿里巴巴的模型在那個環境裡會有顧慮。這是產品定位,跟準確度無關。10 月 24 日決定 Breeze 維持預設,Qwen 放在「設定 → 錄音與轉錄 → 正式轉錄」當第二個選項,說明文字寫明是阿里巴巴開源的模型、全程在這台 Mac 上跑、不連網、要下載約 2.5 GB。沒選它的人不會下載任何東西,流程跟 4.0.0 一模一樣。
Breeze 還有兩個地方比較好。說話者標對率它是 97.2%/96.1%,Qwen 的實作是 96.3%/93.8%,因為 Qwen 的段落最長 15 秒,比 whisper 的粗,搶話多的會議標錯的比例高一些。另一個是中英夾雜的訓練資料就是針對台灣,單人講課 3.8% 對 6.6%。
日文另外一套
日文會議三個模型都試過。Breeze 會把片假名外來語寫成英文。kotoba-whisper v2.0 在 whisper.cpp 上會亂輸出、整句漏掉。Qwen3-ASR 日文聽證 17.1%。最後用 Whisper large-v3-turbo q5_0(574 MB),國會聽證 9.2%/7.7%,合成會議 4.5%,而且標準答案用的國會會議錄本身刪掉了語助詞,實際錯誤率會比這個低。只有第一次轉錄日文會議時才下載。
語言偵測也不能用 Breeze,它會把英文判成中文。偵測用 Whisper base q5_1,60 MB,錄音開始後收滿 10 秒有聲音的片段就判一次。
詞彙表當提示詞有多大用
這是 Breeze 從第一版就在用的做法,詞彙表以「、」隔開塞進 initial_prompt,中文 150 字、英文 400 個字元以內。合成的中英夾雜會議裡六個關鍵詞,加詞彙表對五個,不加的 macOS 內建辨識對一個,CER 3.2% 對 5.8%。Qwen 接上後用同一份詞彙表當 context,上限一樣。
試過但沒採用的
- 轉錄前的語音活動偵測(VAD):whisper.cpp 內建的那個,開了之後 AISHELL-4 從 30.5% 惡化到 38.4% 到 47.8%,只有乾淨的合成錄音變好。它想解決的「安靜時憑空產生文字」,事後過濾已經擋掉大部分。
- 麥克風跟電腦聲音分聲道各自轉錄:只在戴耳機的線上會議有幫助,錯誤率少約 3 個百分點;有回音時沒有比較好,說話者標對率還從 95% 掉到 79%~88%,速度減半。設定裡沒開放,要測得用 defaults 寫隱藏鍵。
- 只調 Breeze 的參數:上面講過,差不到 1%。
自己重跑
拾音 DEBUG 版的 shiyinctl transcribe-eval <錄音> <設定.json> <輸出.json> 走 app 真正的轉錄流程,不建會議、不寫資料庫,設定可以指定引擎、語言、詞彙表、分聲道、回音處理。評分用 asr-score.swift,正規化規則和混淆統計都在裡面。資料集的來源、授權和下載位置在 docs/design.md 第 32 節。AISHELL-4 和 AMI 都是公開語料,TaiMECS 是 CC BY 4.0。
數字是 2026 年 10 月 24 日的,模型版本是 Breeze ASR 25 q8_0、Qwen3-ASR 1.7B q8_0(ggml-org/Qwen3-ASR-1.7B-GGUF)、llama.cpp b8769 之後的版本。模型更新了數字會變,重跑比引用快。
常見問題
Qwen3-ASR 比較準,為什麼拾音預設不用它?
數字上 Qwen 最好,AISHELL-4 是 17.5% 對 Breeze 的 25.7%。但拾音的使用者是台灣的公司,阿里巴巴的模型會有顧慮,所以 2026 年 10 月 24 日決定只當選項,預設維持聯發科的 Breeze。設定裡選 Qwen 時會寫明是阿里巴巴開源的模型、全程在這台 Mac 上跑、要下載約 2.5 GB。
macOS 內建的語音辨識不用下載模型又快 160 倍,為什麼不直接用它?
它在遠距收音的中文會議上錯誤率跟 Breeze 差不多,但中英夾雜的專有名詞幾乎都錯。合成的中英夾雜會議裡六個關鍵詞它只對一個,Breeze 加詞彙表對五個。台灣公司的會議就是這種情況,所以它是選項,不是預設。
自己想重跑這些數字要怎麼做?
拾音的 DEBUG 版有 shiyinctl transcribe-eval,用 app 真正的轉錄流程跑一段錄音,可以指定引擎、語言、詞彙表;再用 scripts/dev/asr-score.swift 算 CER 或 WER。資料集用 AISHELL-4 的 M_R003S01C01、AMI 的 ES2004a 都是公開的。
Windows 版也有 Qwen3-ASR 嗎?
有,4.1.0 一起上。Windows 用 llama-server 子程序,模型跟執行檔一起下載,分段與簡轉繁的規則跟 Mac 同一份標準答案比對。