語音辨識模型比較:Qwen3-ASR、Whisper、SenseVoice、Breeze 官方分數和會議實測差三倍
語音辨識模型的官方錯誤率多在 2~8%,同一個模型轉真實會議是 17~32%。這篇把 Qwen3-ASR、SenseVoice、Whisper、Breeze ASR 25 的官方數字和拾音的會議實測對起來,說明差距從哪來、官方數字怎麼用。
重點
- 同一個模型轉真實會議,錯誤率是官方的 2~4 倍。Qwen3-ASR 1.7B 官方 5.88%,六人遠距收音的中文會議 17.5%。
- 排行榜的 AMI 和拾音測的是同一場會議。每人一支麥克風、切好的短句 8.31%,混成一軌整場轉 31.3%,多出來的錯七成是漏字。
- 官方數字只能刪掉差很多的模型,差幾個百分點的要拿自己的會議錄音量。
目錄
語音辨識模型官方公布的錯誤率,跟拿去轉會議差兩到四倍。這篇把 Qwen3-ASR、SenseVoice、Whisper、Breeze ASR 25 的官方數字跟拾音的會議實測對起來。拾音怎麼量的寫在〈Mac 本機轉錄中文會議誰準〉。
官方數字
| 模型 | 乾淨朗讀 | 最接近會議的 | 出處 |
|---|---|---|---|
| Qwen3-ASR 1.7B | AISHELL-2 2.71% | WenetSpeech test_meeting 5.88% | model card |
| Qwen3-ASR 0.6B | AISHELL-2 3.15% | WenetSpeech test_meeting 6.88% | 同上 |
| SenseVoice-Small | AISHELL-1 2.96% | WenetSpeech test_meeting 7.44% | 論文表 6 |
| Paraformer-large | AISHELL-1 1.95% | WenetSpeech test_meeting 6.97% | ModelScope |
| FireRedASR-AED | AISHELL-1 0.55% | WenetSpeech test_meeting 4.76% | 論文表 2 |
| Whisper large-v3 | AISHELL-1 5.14% | WenetSpeech test_meeting 18.87% | SenseVoice 論文表 6,代量 |
| Breeze ASR 25 | Common Voice 16 台灣華語 7.97% | 沒公布 | 論文表 IV |
| TEA-ASR 1.1 | Common Voice 19 台灣華語 3.58% | 沒公布 | model card |
沒有一家公布遠距多人會議(AISHELL-4、AliMeeting)的成績。同一個模型不同人量的也不一樣,Whisper large-v3 在 WenetSpeech 會議集有 18.87%(SenseVoice 論文)和 19.11%(Qwen 的 model card)兩個數字,比較要用同一份表。
拿去轉會議
實測是拾音的轉錄流程,去掉語助詞後算。中文是 AISHELL-4(6 人、遠距、38 分鐘),英文是 AMI ES2004a,日文是日本國會聽證。實測數字記在拾音 repo 的 design.md §32.1,SenseVoice 那列在 design-windows.md D61,逐次的替換、刪除、插入字數在原始評估紀錄。
| 模型 | 官方 | 會議實測 | 倍數 |
|---|---|---|---|
| Qwen3-ASR 1.7B,中文 | 5.88% | 17.5% | 3.0 |
| Qwen3-ASR 0.6B,中文 | 6.88% | 17.0% | 2.5 |
| SenseVoice-Small,中文 | 7.44% | 26.4% | 3.5 |
| Breeze ASR 25,中文 | 7.97%(朗讀) | 25.7% | 3.2 |
| Qwen3-ASR 1.7B,英文 | 8.31% | 31.3% | 3.8 |
| Whisper large-v3-turbo,日文 | 4.7% | 9.2% | 2.0 |
| Qwen3-ASR 1.7B,日文 | 5.20% | 17.1% | 3.3 |
官方英文出自 Open ASR Leaderboard,日文出自 OpenAI 的 turbo 發布說明和 Qwen 的技術報告附錄表 A.2。
差距從哪來
AMI 最清楚,因為排行榜和拾音用的是同一場會議(ES2004a 在 AMI 官方測試集裡)。排行榜用每個人自己的頭戴麥克風,照標註切成短句(ESB 論文第 3 節與附錄 A)。拾音把四支麥克風混成一軌,整場直接轉。收音距離沒變,Qwen3-ASR 1.7B 從 8.31% 變 31.3%。
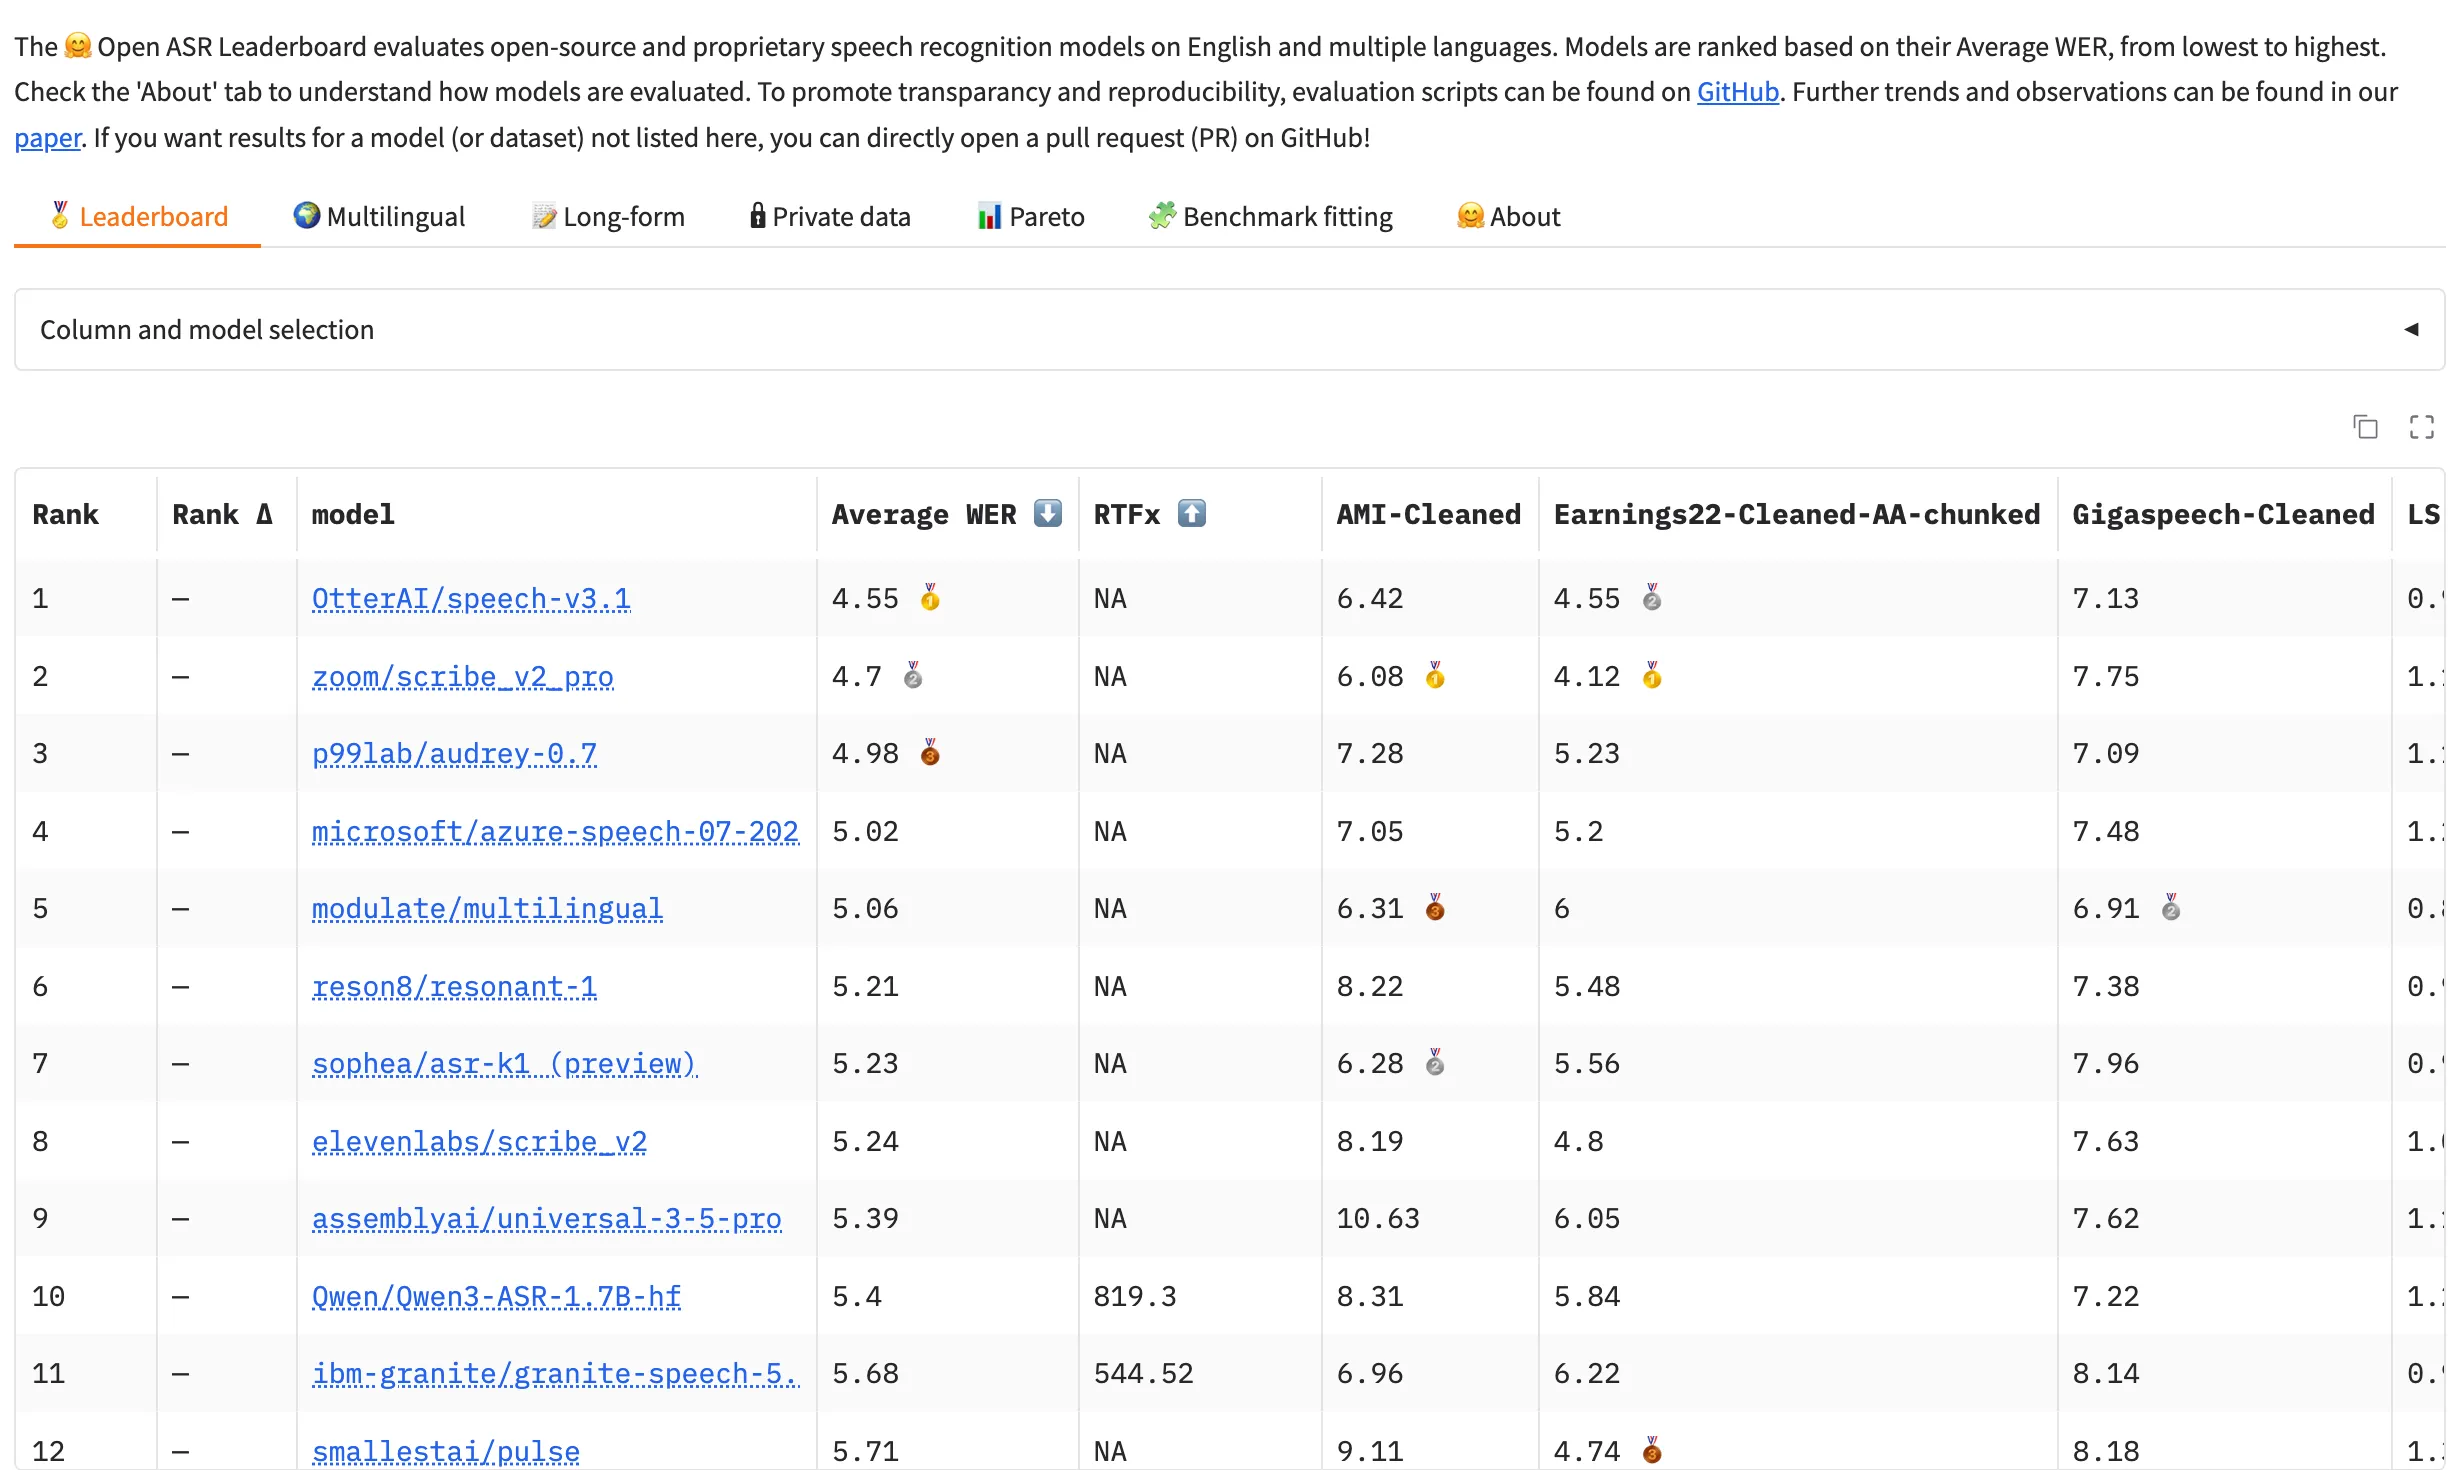
Open ASR Leaderboard,2026 年 10 月 27 日。Qwen3-ASR 1.7B 的 AMI 是 8.31,Whisper large-v3 是 13.63。
收音距離是另一筆。Whisper large-v2 在 AMI 頭戴麥克風 16.9%,換成遠處麥克風 36.4%(Whisper 論文表 8)。
多出來的錯大多是漏字。乾淨句子兩個模型都約 2%,會議裡刪除變成 9~23 個百分點,AMI 上佔七成。漏多少跟切段有關:同一個 Qwen,AMI 30 秒一段 31.6%,15 秒一段 39.6%。
遠距多人會議本來就難。AISHELL-4 論文的基準系統是 30~33%,2022 年 M2MeT 挑戰冠軍是 18.79%(論文)。
排名會翻
- TEA-ASR 1.1(Qwen3-ASR 1.7B 微調):自家表上 3.58% 贏原版 3.90%,六人會議 34.8% 對 16.2%(design.md §32.1)。
- macOS 內建,日文:FLEURS 朗讀 7.0% 最好,國會聽證 15.2% 最差(原始評估紀錄)。
- 英文:排行榜上 Qwen 比 Whisper large-v3 少 5 個百分點,整場會議 Qwen 對 Breeze 只差 1.3。
官方數字怎麼用
- 中文看 WenetSpeech test_meeting,英文看排行榜的 AMI。乾淨朗讀集大家都在 1~3%,分不出會議表現。
- 差兩三倍的可以先刪,例如 Whisper large-v3 在 WenetSpeech 會議集 18.87%,其他在 4.8~7.4%。
- 差幾個百分點的,拿自己的會議錄音量。工具在拾音 repo:
shiyinctl transcribe-eval跑轉錄,asr-score.swift 算分。
AISHELL-4 和 AMI 各只量了一場,數字是 2026 年 10 月的版本。
常見問題
Qwen3-ASR 官方說錯誤率 2% 多,為什麼轉會議是 17%?
官方的 2.71% 是 AISHELL-2,近距收音、切好的短句。拾音量的是 AISHELL-4,六個人、遠距麥克風、38 分鐘整段轉,多出來的錯大多是多人同時說話時漏掉的字。
選會議轉錄的模型要看哪個 benchmark?
中文看 WenetSpeech test_meeting,英文看 Open ASR Leaderboard 的 AMI。兩個都是切好的短句,只能刪候選,最後要用自己的會議錄音量。